admin
·
深入浅出阅读OpenAI强化学习经典论文《Proximal Policy Optimization Algorithms》
本文深入浅出地解析了OpenAI强化学习经典论文《Proximal Policy Optimization Algorithms》,从工程视角将PPO算法中的“策略”类比为控制器,帮助非专业背景的读者理解其核心思想。文章详细介绍了PPO的提出背景,指出其在解决传统强化学习算法(如DQN、策略梯度方法和TRPO)的稳定性与复杂性难题中的优势。重点分析了PPO的核心创新——“裁剪”目标函数,通过限制策略更新幅度,在保证训练稳定性的同时简化实现。此外,文章还阐述了PPO的三步工作流程(数据收集、优势计算和优化)及其在连续控制任务和雅达利游戏中的卓越实验效果,最终总结了PPO在样本效率、易用性和...
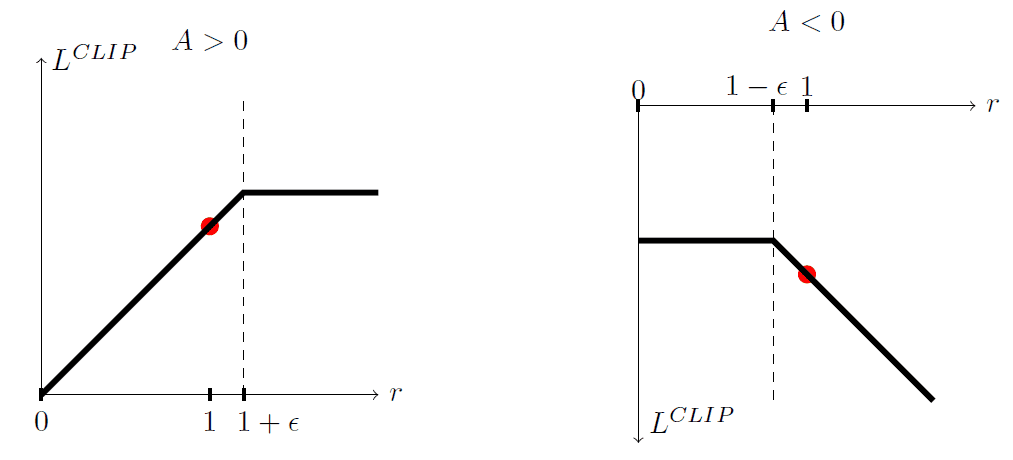


最近评论