强化学习代码中的两种触发更新策略方式:基于步数与基于轨迹数
本文系统对比了强化学习中两种核心的更新触发策略——基于步数与基于轨迹数,分析其原理、优劣及适用场景。基于步数的策略以固定环境交互步数(如8192步)触发更新,支持数据截断与价值函数bootstrap估计,适合连续控制、长周期任务及资源受限场景,具备高样本效率与稳定计算开销。基于轨迹数的策略则以完整episode数量(如64个)为更新条件,依赖真实终止状态回报估计,更适用于目标明确、episode长度适中、奖励稀疏的任务,能保持任务语义完整性与理论一致性。文章通过多维度对比,为不同强化学习任务场景下的策略选择提供实用指南。
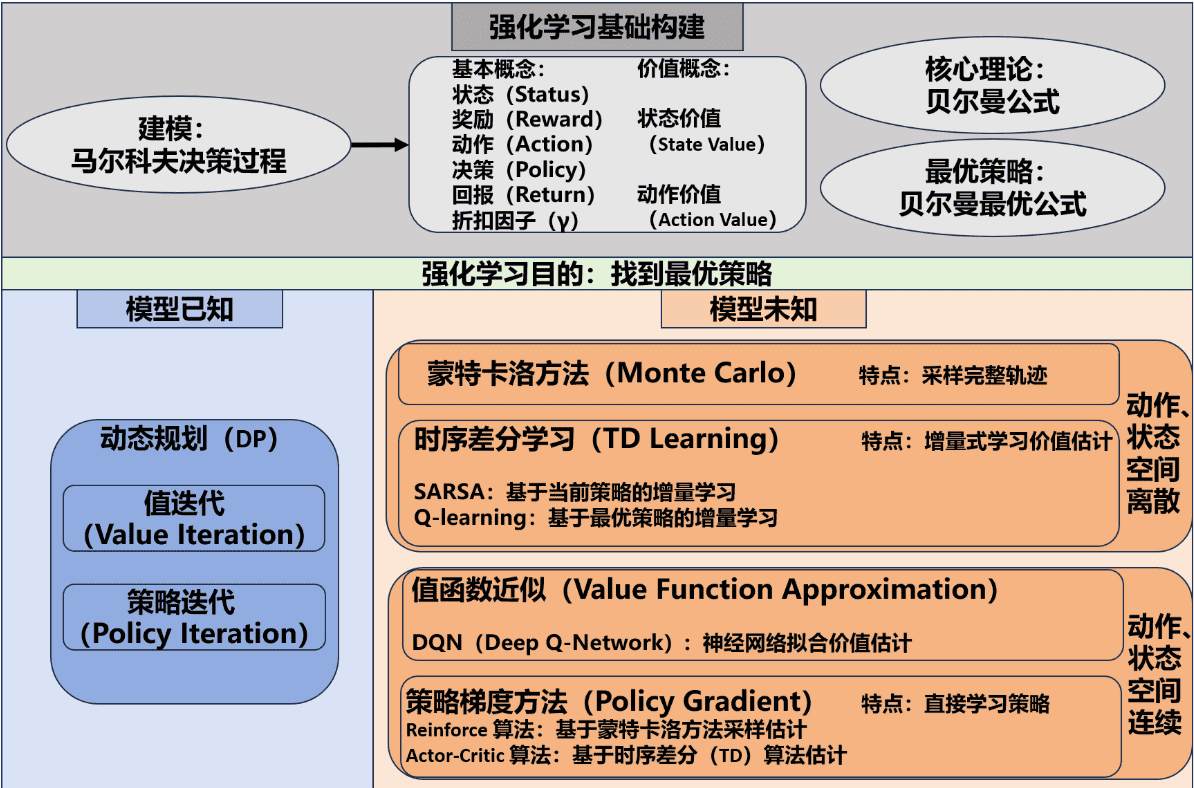
在强化学习算法(特别是 PPO 等策略梯度方法)的实际实现中,一个关键的工程决策是:什么时候触发策略网络的更新?这直接影响算法的样本效率、训练稳定性和计算资源利用。本文将深入探讨两种主流的更新触发策略,并提供选择指南。
一、什么是基于步数的更新策略
基于步数(Timestep-based) 的更新策略以环境交互的总步数作为触发条件。例如,设定"每收集 8192 个 step 就进行一次策略更新"。
在这种模式下,算法并不关心轨迹(episode)是否完整结束。智能体可能在一个 episode 的中途就停止收集数据,进行更新,然后继续与环境交互。具体来说:
- 数据收集:持续与环境交互,直到累计达到预设的步数阈值(如 8192 步)
- 更新时机:无论当前 episode 是否结束,只要步数达标就立即更新
- 轨迹处理:可能包含多个完整的 episode,也可能包含被"截断"的不完整 episode
在基于步数的策略中,对于未完成的 episode,通常采用 bootstrap 技术来估计未来回报:
如果 episode 未结束:
    V_next = Critic(last_state)  # 用价值网络估计剩余回报
    advantages = compute_gae(..., V_next)
这种方法允许算法利用价值函数的预测能力,即使没有完整的轨迹信息也能进行有效的优势估计。
二、什么是基于轨迹数的更新策略
基于轨迹数(Trajectory/Episode-based) 的更新策略以完整的 episode 数量作为触发条件。例如,"每收集 64 个完整的 episode 更新一次"。
这种模式要求每次更新时,所有用于训练的数据都来自已经自然结束的 episode:
- 数据收集:持续进行 episode,直到完成的 episode 数量达到预设阈值(如 64 个)
- 更新时机:只在 episode 自然终止(达到目标、失败或超时)后计入计数
- 轨迹处理:所有数据都是完整的轨迹,从初始状态到终止状态
在基于轨迹数的策略中,优势估计可以利用真实的终止信息:
对每个完整的 episode:
    if terminated:
        V_next = 0  # 真实的终止状态
    advantages = compute_gae(..., V_next)
这种方法特别适合那些 episode 语义明确的任务,比如完成一个具体目标(画完一个圆、到达终点等)。
三、两种策略的对比分析
| 对比维度 | 基于步数 (Timestep-based) | 基于轨迹数 (Trajectory-based) |
|---|---|---|
| 触发条件 | 收集固定步数(如 8192 步) | 收集固定 episode 数(如 64 个) |
| 轨迹完整性 | 可包含截断的不完整 episode | 全部为完整的 episode |
| 价值估计 | 使用 Critic 进行 bootstrap 估计 | 使用真实的终止状态(V=0) |
| 样本效率 | ✅ 高 - 不浪费未完成的数据 | ❌ 较低 - 可能丢弃未完成数据 |
| 计算开销 | ✅ 固定且可预测 | ❌ 不固定,取决于 episode 长度 |
| 长 episode 适应性 | ✅ 优秀 - 无需等待完成 | ❌ 较差 - 需长时间等待 |
| GAE 计算 | 较复杂 - 需处理截断情况 | ✅ 简单 - 无边界问题 |
| 回报估计准确性 | 依赖 Critic 质量,可能有偏差 | ✅ 更准确 - 使用真实终止信息 |
| 理论一致性 | 与部分理论假设有偏差 | ✅ 符合完整轨迹假设 |
| 训练稳定性 | ✅ 更新频率均匀 | 可能因 episode 长度波动 |
| 显存管理 | ✅ 易于控制批量大小 | 批量大小可能波动 |
| 语义完整性 | 可能打断任务逻辑 | ✅ 保持完整任务语义 |
| 稀疏奖励任务 | 需要良好的价值估计 | ✅ 更适合 - 完整信用分配 |
| 典型应用 | MuJoCo 机器人控制 | 游戏关卡、画图任务 |
四、如何选择:适用场景
(1)适合基于步数策略的场景
连续控制任务
(MuJoCo, 机器人控制)
- Episode 通常很长(数千步)
- 状态转移连续平滑
- 价值函数通常能给出较准确的 bootstrap 估计
- 典型例子:Ant-v4, HalfCheetah-v4, Humanoid-v4
无明确终止条件的任务
- 需要持续运行的系统
- 或者终止条件非常稀疏
- 典型例子:无限地平线的导航任务
计算资源受限时
- 需要精确控制每次更新的批量大小
- GPU 显存有严格限制
- 需要可预测的训练时间
(2)适合基于轨迹数策略的场景
明确目标导向的任务
- Episode 有清晰的成功/失败标准
- 终止状态信息对学习很重要
- 典型例子:画图任务(画完一个形状)、游戏关卡(通关或失败)
Episode 长度适中的任务
(数十到数百步)
- 不会因为等待 episode 完成而浪费太多时间
- Episode 长度相对均匀
- 典型例子:CartPole, LunarLander, 简单的迷宫任务
稀疏奖励任务
- 只在 episode 结束时给予奖励
- 需要完整轨迹来进行信用分配
- 典型例子:只有最终成功才有奖励的任务
理论研究或基准测试
- 需要与理论分析保持一致
- 需要与文献中的设置对齐
本文章是52txr原创文章,未经许可,禁止转载,禁止任何AI爬虫使用本网站内容。开源小栈是陶小桃Blog纯技术/知识的分身网站,欢迎每一位访客朋友。

暂无评论数据